Voy al grano, porque lo útil aquí es una lista de comprobaciones, no un ensayo.
Casi todas las pymes configuran las reglas de bots de su web una vez, en cinco minutos, y no vuelven a mirarlas. Como forma de llevar una empresa, es razonable. Deja de serlo cuando una empresa que no conoces cambia lo que significan tus ajustes y te lo cuenta en una sola frase enterrada en el blog corporativo: que «en casi todos los casos no hay nada que hacer».
Qué cambió exactamente el 15 de septiembre
Cloudflare está delante de buena parte de internet y vende un conjunto de controles para decidir qué bots atiende tu web. En su anuncio del 15 de septiembre de 2026, la compañía lanzó un ajuste nuevo y cambió el significado de uno antiguo.
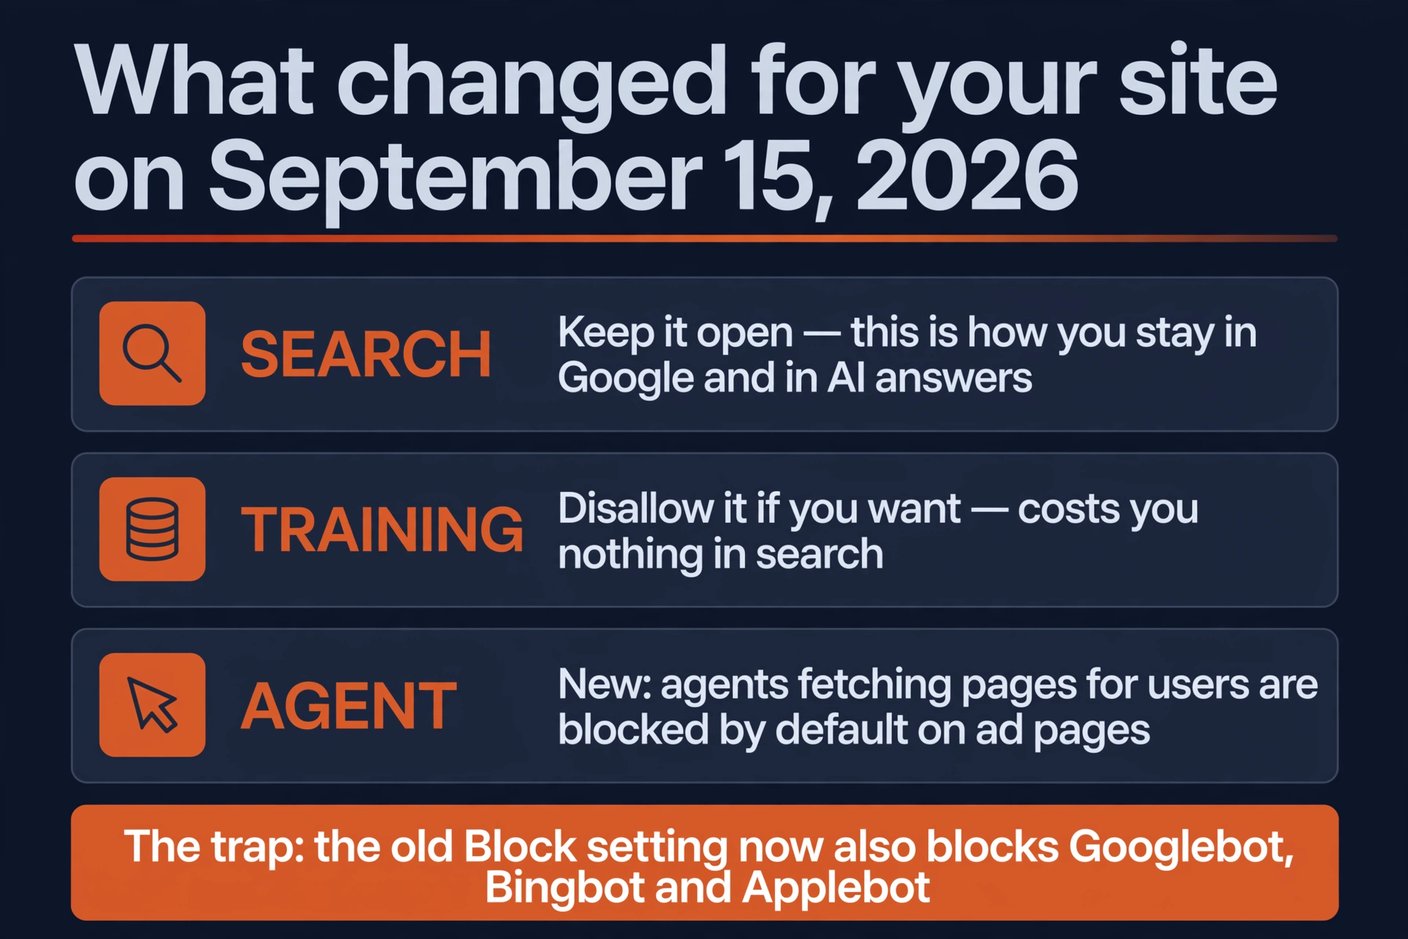
El nuevo se llama Disallow AI Training. Si lo activas, Cloudflare escribe una regla de no-entrenamiento en tu robots.txt, bloquea a los rastreadores que solo entrenan —los de Amazon, Anthropic, Meta y OpenAI— y deja que los grandes rastreadores «de uso mixto» sigan indexándote para las búsquedas. Uso mixto significa un rastreador haciendo dos trabajos: Applebot, Bingbot y Googlebot rastrean para las búsquedas y alimentan el entrenamiento de la IA en esas mismas visitas. Con el ajuste nuevo siguen viniendo a buscar, pero se les prohíbe el entrenamiento.
El ajuste antiguo es el problema. Cloudflare agrupa los bots en tres comportamientos —Search (búsqueda), Training (entrenamiento) y Agent (agentes)— y hasta el 15 de septiembre las opciones más contundentes, Block y Block on pages with ads, se saltaban a propósito los rastreadores de uso mixto, precisamente porque bloquearlos se lleva por delante tu presencia en los buscadores. Esa excepción ya no existe. Block ahora bloquea todo, Googlebot incluido.
La propia recomendación del proveedor cabe en una frase: «Qué tienes que hacer: nada, en casi todos los casos. Tus ajustes actuales se mantienen solos». Es cierto en sentido estricto. Tus ajustes sí se mantienen. Lo que no se ha mantenido es lo que hacen.
La trampa: Block ya no significa lo que elegiste
Aquí está la parte que merece diez minutos de tu tiempo. Cloudflare publicó una tabla de migración para los dominios que habían usado el antiguo interruptor «Block AI Bots». La intención que expresaste se respeta: el entrenamiento sigue prohibido. Pero mira qué más se mueve.
| Lo que elegiste antes | Búsqueda | Entrenamiento | Agentes |
|---|---|---|---|
| Block AI Bots: desactivado | Permitir | Permitir | Permitir |
| Block AI Bots: activado | Permitir | Disallow AI Training | Block en páginas con anuncios |
| Block AI Bots: solo anuncios | Permitir | Disallow AI Training | Block en páginas con anuncios |
Así que una web que tenía activado Block AI Bots acaba en un sitio sensato, y una que nunca tocó el ajuste lo mantiene todo abierto. El daño está en la otra dirección, y Cloudflare lo dice con todas las letras: si ahora quieres que los rastreadores de uso mixto desaparezcan del todo, «tienes que decirlo. Selecciona Block. Impedirá que Applebot, Bingbot y Googlebot lleguen a tu web, incluida la búsqueda».
O sea que cualquier dueño que eligió Block como un gesto genérico de «nada de IA con mi contenido» —algo normal en 2024 y 2025, cuando todos los artículos te decían que bloquearas los rastreadores de IA— arrastra hoy un ajuste que lo saca de Google. Sin correo, sin aviso en el panel, sin ningún error. Tu web sigue cargando para quien ya te conoce, y el tráfico orgánico cae poco a poco sin que nadie te lo diga.
La parte que de verdad es una buena noticia
Hasta hace poco, entrenamiento y búsqueda iban soldados en los tres rastreadores más grandes, y por eso esta decisión siempre era fea: rechazar el entrenamiento significaba rechazar las visitas que te encuentran. Cloudflare pasó el verano discutiendo con Apple, Google y Microsoft para separarlos, y consiguió un resultado que conviene entender aunque nunca uses Cloudflare.
Los tres operadores ahora llevan una etiqueta llamada Accountable, y no es decorativa. Para obtenerla, un operador tiene que ofrecer una forma de que el dueño de una web se excluya del entrenamiento mediante robots.txt, dar una manera de excluirse de los resúmenes generados con IA, mostrar qué páginas tuyas se pusieron a disposición del entrenamiento y declarar que excluirse no afectará a tus resultados normales de búsqueda. En la práctica, para una pyme eso significa una cosa: ahora puedes decir que no al entrenamiento sin desaparecer de los buscadores.
Google respeta el token Google-Extended para el entrenamiento mientras Googlebot sigue indexándote, y tanto Google como Apple han declarado que elegir no entrenar no cambia el ranking en las búsquedas. Microsoft va más atrás: la preferencia sobre entrenamiento de Bingbot se expresa hoy con la etiqueta meta NOARCHIVE, y el soporte de robots.txt a nivel de dominio está previsto para principios de 2027, así que un ajuste de no-entrenamiento de Cloudflare todavía no llega a Bing por el archivo estándar.
Hay un dato del anuncio que merece quedarse en la cabeza. Menos del 1% de los sitios en Cloudflare bloquea a los bots de búsqueda, y un 17% bloquea el entrenamiento de alguna forma. Dieciséis de cada diecisiete personas que querían la IA fuera de su contenido no querían quedarse fuera de Google, y hasta este mes las herramientas casi nunca les dejaban separar una cosa de la otra.
La comprobación de 30 minutos para tu propia web
No hace falta ser cliente de Cloudflare para que esto te afecte. Más o menos un tercio de las webs de pyme que reviso han heredado una regla de bots de un antiguo propietario, de una agencia o de un plugin que se instaló una vez y se olvidó. Haz estas cuatro comprobaciones, en este orden.
Primero, mira tu robots.txt. Abre tudominio.com/robots.txt en el navegador. Busca un Disallow: / bajo un user-agent llamado Googlebot, Bingbot o un * a secas. Si lo ves, arréglalo antes de nada más: un disallow con comodín te saca de todos los buscadores a la vez, y es la errata más cara que puede publicar una web pequeña.
Segundo, revisa los ajustes en el borde, no solo el archivo. Una CDN o una capa de seguridad puede inyectar reglas de bots que nunca aparecen en el archivo que sirve tu servidor. Si usas Cloudflare, eso está en los ajustes de seguridad del dominio; si usas un plugin de seguridad de WordPress, busca una sección de bots o de cortafuegos. El orden que aplica Cloudflare es Permitir, luego Disallow AI Training, luego Block en páginas con anuncios y luego Block, y solo el último es peligroso para tu tráfico de búsqueda.
Tercero, busca tu dominio en Google y hazte una pregunta. ¿Sigue apareciendo un resultado y la descripción parece escrita a partir de tu página? Una página bloqueada pero enlazada suele quedarse listada sin descripción alguna. Si los resultados se ven flojos, compáralos con el informe de cobertura de Search Console y busca páginas que hayan pasado hace poco a «bloqueada por robots.txt».
Cuarto, date cuenta de que los agentes son ahora un grupo aparte. Cloudflare clasifica como comportamiento propio los agentes dirigidos por un usuario —los bots que traen una página porque una persona lo ha pedido, ya sea un chat o una herramienta de navegación— y en los dominios nuevos que se monetizan con anuncios ese bloqueo ya viene activado por defecto. Si tienes automatizaciones que leen webs de terceros, puede que este sea el motivo de que alguna empezara a devolver un 403 esta semana.
Si no usas Cloudflare, la misma decisión sigue aplicándose
La separación está ocurriendo en todo el sector, no en una sola red, así que escribe tu propia regla. En un robots.txt normal el patrón es una lista de user-agents, cada uno con su permitir o prohibir. Bloquea los rastreadores de entrenamiento que te molesten —GPTBot, ClaudeBot, CCBot, Applebot-Extended, Google-Extended— y deja en paz a los rastreadores de consulta, los que deciden si un asistente puede citarte: OAI-SearchBot, Claude-SearchBot, PerplexityBot. A Googlebot no lo bloquees nunca.
Dos advertencias honestas. El robots.txt es una petición, no un muro: funciona porque los proveedores con departamento jurídico deciden respetarlo, y a ByteDance y a Perplexity ya les han pillado ignorándolo. Y una regla que no sabes explicar es una regla que no deberías mantener. Me he encontrado con más de una empresa que llevaba bloqueando su propio tráfico de búsqueda desde 2019 porque un técnico externo pegó en el archivo un fragmento de «protege tu contenido de la IA» y nadie volvió a leerlo.
Así que la decisión no es «IA sí o IA no». Son tres respuestas que escribes una vez: búsqueda dentro, entrenamiento fuera y un sí o un no deliberado sobre los agentes. Después, échale un ojo una vez al trimestre, porque la lista de rastreadores cambia y —como ha demostrado este mes— también cambia lo que significan los interruptores.
Preguntas frecuentes
¿Esto me afecta si mi web no está en Cloudflare?
No directamente, pero la decisión de fondo sí. Cloudflare está empujando a los operadores a separar búsqueda de entrenamiento, y Google, Apple y Microsoft han aceptado ese planteamiento. Tu robots.txt de siempre es donde expresas esa misma elección, y escribirlo no te cuesta nada.
Tenía Block AI Bots activado. ¿Estoy fuera de Google?
Compruébalo antes de alarmarte. Mira los ajustes de seguridad del dominio y confirma cuál de los cuatro niveles está activo. Si pone Block, ahora mismo estás bloqueando a Applebot, Bingbot y Googlebot, y deberías pasar hoy mismo a Disallow AI Training. Luego dale un par de semanas a las búsquedas para que se recuperen.
¿Bloquear el entrenamiento con IA perjudica mi visibilidad?
No con la configuración que los proveedores han dejado ahora. Google y Apple afirman que excluirse del entrenamiento no afecta al ranking en las búsquedas, y los rastreadores de consulta que deciden si un asistente te menciona son tokens aparte que puedes dejar abiertos. Lo que sí hace daño de verdad es bloquear los rastreadores de consulta sin querer: ese es el error que hay que evitar.
¿Cómo sé si ahora mismo están bloqueando un rastreador de búsqueda?
Descarga tu propio robots.txt y luego mira los registros de tu servidor o las analíticas de bots de tu CDN para ver las visitas de Googlebot y Bingbot de la última semana. Si han caído a cero mientras el tráfico humano sigue igual, algo más arriba —un archivo, un plugin o un valor por defecto de la red— les está cerrando la puerta.
¿Tengo que hacer algo por Bing antes de principios de 2027?
No es urgente. El soporte de robots.txt a nivel de dominio para las preferencias de entrenamiento de Microsoft está previsto para principios de 2027, y hasta entonces la etiqueta meta NOARCHIVE es la señal disponible. Apúntalo y sigue con lo tuyo; no hay ningún primer paso que cambie algo hoy.
¿No sabes qué le está diciendo tu web a los rastreadores?
En BigLobster revisamos los ajustes que deciden si Google, Bing y los asistentes de IA pueden llegar a la web de una pyme, y dejamos la respuesta por escrito para que deje de ser un misterio. Se tarda menos que en leer este artículo.
Pide que revisemos tu web